iFood
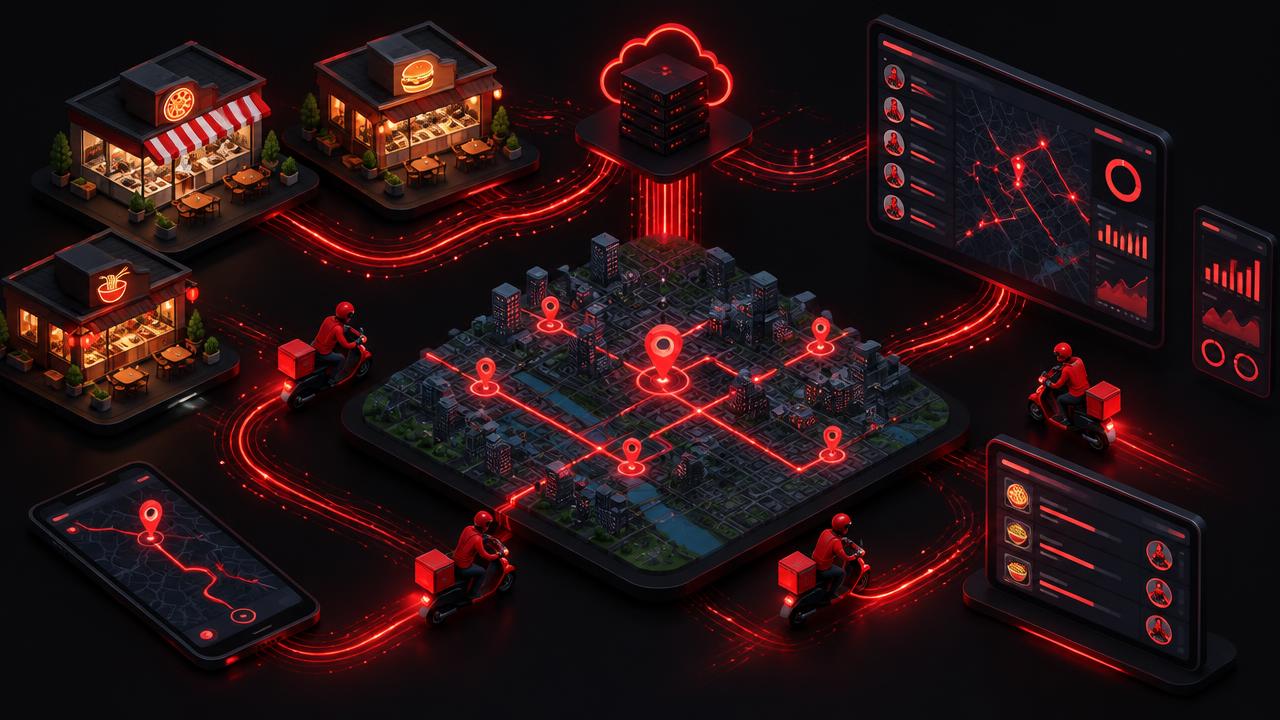
Como o iFood conecta eventos, lakehouse e machine learning para viabilizar entregas.
Números que importam
Stack técnica
A arquitetura em um dashboard interativo
A ideia é essa: aprender lendo o diagrama. Cada caixa e cada seta conta uma parte da história — clique pra abrir.
Cor indica o papel: cliente, streaming, storage, compute, ML, serving. Clique em qualquer caixa pra ver o que é, por que é usada e como funciona ali.
OpcionalLer o deep dive completo em textoAs mesmas ideias do diagrama, com mais contexto — recomendado depois de explorar as etapas.
Eventos em streaming e workflows orquestrados resolvem problemas diferentes
Atualizações de pedidos e entregas importam para muitos consumidores. Streaming permite publicar mudanças sem que o produtor seja dono de toda carga analítica ou de ML.
Airflow orquestra workflows; não é o transporte de cada evento. Separe ingestão contínua de recálculo agendado e defina explicitamente replay, deduplicação e dados atrasados.
O lakehouse como base histórica reutilizável
O material do feature store do iFood conecta Spark, Databricks e tabelas Delta: um histórico único para processamento, features offline e análise, em vez de extrações separadas por consumidor.
Um estudo mais recente da Databricks reporta 67% menos custo de processamento e armazenamento e 70% menos manutenção após migrar para pipelines declarativos — resultados daquela iniciativa, não promessas universais.
Features conectam aprendizado histórico a decisões ao vivo
Usos documentados de ML incluem recomendação de restaurantes e pratos, estimativa do tempo de entrega e alocação de entregadores. Uma previsão é entrada para uma decisão, não o sistema decisório inteiro.
Trate atualização, chaves de entidade e significado histórico como parte do contrato de cada feature, para treino offline e serving online concordarem.
Simulação complementa o dispatch em produção
O estudo de Databricks e Tableau descreve um simulador para testar hipóteses antes de mudar a produção — 10.000 simulações em um único mês.
Esse ciclo é diferente da alocação ao vivo: a simulação avalia políticas; os serviços operacionais agem sobre as condições atuais. Mantenha os dois conectados sem confundi-los.
Fontes e leituras curadas
As fontes públicas por trás desta análise, com nosso comentário sobre por que valem seu tempo.
Aprenda o que faz isso funcionar
As aulas do DataForge que cobrem as peças dessa arquitetura.